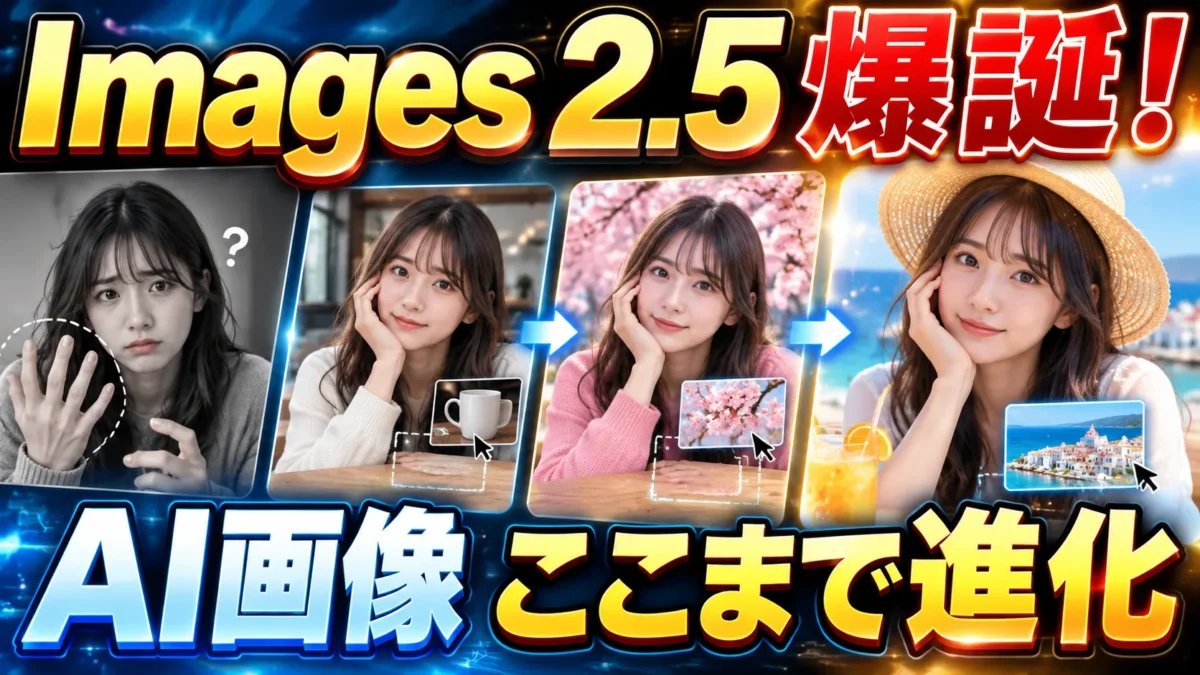
2023年ごろ、AI画像を見分けるときによく話題になっていたのが手でした。
指の本数がおかしい。
関節が不自然。
物を持っているはずなのに、手と物がうまくつながっていない。
当時は、そうした細部の破綻がAIで作った画像かもしれないと気づく手がかりになることもありました。
それから約3年。
2025年にはGoogleのNano Bananaが登場し、同じ人物の顔や雰囲気を保ったまま、服装や背景を変える画像編集が一気に身近になります。
そして2026年9月8日、OpenAIがChatGPT Images 2.5を発表しました。
では、今回は何がそんなにすごいのでしょう。
顔を変えずに服だけ変えるなら、Nano Bananaでもできましたよね?
Images 2.5は、そこから何が変わったんですか?
また前よりリアルになりましたという話ではないですよね?
上記の疑問を解決します。
結論から言うと、Images 2.5を見るなら、最初にできた1枚だけでは足りません。
見るなら、そのあとです。
背景を変える。服を変える。商品を足す。構図を直す。
さらにもう一度修正する。
OpenAIはImages 2.5について、こうした複数回の編集でも、前に直した内容を保ちながら次の修正を重ねやすくなったと説明しています。
しかも、画像に直接コメントする、ラフを描いて伝える、テンプレートから作り始めるといった新しい操作も追加されました。
Nano Bananaで同じ人物を保って編集できることに驚いた人も多いと思います。
Images 2.5は、何度も直したあとに、最初に気に入った部分がどこまで残っているか。そこを見ると進化が分かりやすいですよ
この記事でわかること
- Nano Bananaですでにできていたことと、Images 2.5で注目したい変化
- なぜAI画像は1回きれいに作れるだけでは仕事で使いにくいのか
- 3回、5回と修正できることが制作で重要な理由
- ChatGPTだけでなく、画像生成AI全体で何が変わっているのか
- AI画像が自然になるほど注意したいこと
顔はそのまま、服だけ変更は、もう新しくない
まず、ここは分けて考えた方が分かりやすいです。
顔を保ったまま服や背景を変えられること自体は、Images 2.5で突然できるようになったわけではありません。
Googleは2025年8月にNano Bananaを発表したときから、人物やペットの見た目を保ったまま、服装や背景、ポーズなどを変えられることを大きな特徴としていました。
さらに2026年2月のNano Banana 2でも、人物などの見た目を保つSubject consistencyや、複雑な指示への対応が主要な改善点として挙げられています。
つまり、服だけ変えたいのに、顔まで変わる。
という問題は、すでに画像生成AI全体で大きく改善されてきた部分です。
それなら、Images 2.5の何がニュースなんでしょう?
Images 2.5とNano Banana 2を単純に比べて、どちらが上と言い切ることはできません。
ただし、OpenAIの発表を見ると、今回どこに力を入れたのかははっきりしています。
1回だけうまく編集できることではなく、修正を重ねても前の内容を壊しにくくすること。
OpenAIはこれをMulti-turn editing consistencyとして紹介しています。
長いやり取りの中でも、以前の変更を維持しながら新しい編集を積み重ねやすくなり、何度も修正したときの画質低下も抑えやすくなったとしています。
顔を残せるだけなら、もうImages 2.5だけの話ではありません。
今回見るべきなのは、同じ画像を何度も直しながら完成に近づけられるかどうかです。
Images 2.5は、1回目より3回目以降を見たい
たとえば、SNS広告用の画像を作るとします。
最初に人物と商品が入った画像を作った。
ここまではいい。
ところが実際の制作では、そこからが始まりです。
1回目の修正で、背景を明るくする。2回目で、人物の服を変える。
3回目で、商品の位置を右へ動かす。
4回目で、文字を追加する。
5回目で、「やっぱり商品を少し大きくしたい」となる。
この5回目で、最初に気に入っていた人物の顔が変わったり、2回目で直した服が元に戻ったりしたら困ります。
画像はきれい。
でも、直すたびに前の修正が壊れる。
これでは実際の制作には使いにくい。
Images 2.5でOpenAIが改善点として挙げているのが、まさにこの部分です。
前の編集内容を維持しながら、新しい編集を重ねる複数回編集の一貫性が強化されています。
ここは、最初の1枚だけを比べても分かりません。
これから画像AIを比べるなら、1枚目より3回目、5回目を見た方がいい。
何度か直したあとでも、人物は同じか。
商品の形は残っているか。
背景は勝手に変わっていないか。
前に直した部分が元へ戻っていないか。
そうしたところに、実際の使いやすさが出てきます。
しかもImages 2.5では、Images 2.0と比べて画像生成の待ち時間が最大50%短縮されたとOpenAIは発表しています。
ChatGPT ImagesとAPIのGPT‑Imageモデルでは、すでに毎週30億枚以上の画像が作られているため、何度も試して直すなら速度の差も無視できません。
AIマンガも分かりやすい例です。
1コマだけなら、きれいな主人公を作れる。
問題は2コマ目、3コマ目。
顔が変わる。
服装が変わる。
髪の長さまで変わる。
以前、ChatGPT Images 2.0やNano Bananaを使ったAIマンガ制作、はじめました。夢の漫画家デビューとデザインスキルの話を紹介しました。
同じキャラクターを何度も使う制作では、一貫性がそのまま使いやすさにつながります。
画像を直すたびに、長い説明を書かなくてもよくなってきた
Images 2.5でもう一つ注目したいのは、画像そのものの性能だけではありません。
AIへの伝え方も変わっています。
これまで画像を修正するときは、
画面右側の商品だけ少し大きくして、人物と背景と文字は変更せず……
と文章で説明することが多くありました。
Images 2.5では、生成した画像へ直接コメントを付けて、変更したい場所を指定できます。
さらにSketchでは、文章で説明しにくい配置を簡単な絵で伝えられる。
チラシや商品写真などから始められるテンプレートも追加されました。
これは「便利な新機能が3つ増えました」というだけの話ではありません。
文章だけでAIへ指示する必要がなくなってきています。
指す。描く。直す。また確認する。
人がデザインを修正するときのやり取りに、少し近づいてきました。
Sketchやコメントって、結局は操作が簡単になっただけでは?
操作が簡単になったことも重要です。
ただ、それ以上に大きいのは、最初に完璧な指示を書かなくても制作を続けられることでしょう。
「全部説明してから作ってもらう」のではなく、とりあえず作る。
見てから直す。
さらに見て調整する。
普段、人が画像を作るときと同じ流れです。
画像生成でも『完璧なプロンプトを書かなきゃ』から少し離れられそうです。
言葉で難しければ描く。場所を説明しにくければ画像を指す。直しながら作れる方が、初心者には使いやすいと思います
ChatGPTだけがすごい?実は、画像生成AI全体の競争が変わっている
ここまで読むと、
「Images 2.5が他のAIを一気に追い越した」ように見えるかもしれません。
そこまでは言えません。
Googleも2026年2月にNano Banana 2を公開し、高品質な画像生成だけでなく、高速な高度編集や被写体の一貫性を特徴として打ち出しています。
つまり、面白いのはOpenAI対Googleの勝ち負けではありません。
画像生成AIで競う場所そのものが変わってきています。
以前なら、「どちらが本物みたいな画像を作れる?」が分かりやすい比較でした。
いまは、それだけでは足りません。
同じ人物を使い続けられるか。
一部分だけ直せるか。3回、5回と修正を重ねられるか。
複雑なレイアウトにも対応できるか。
修正にどれくらい時間がかかるか。
OpenAIもGoogleも、こうした実際の制作に近い部分を強化しています。
2023年には手をうまく描けるか、が話題になっていました。2025年には同じ人物を保って編集できるかです。
そして2026年には、一度作った画像を、そのまま何度も直し続けられるか。
数年で、比べるポイントそのものが変わっています。
ここまで自然に直せると、「AI画像を見抜く方法」も変わる
画像生成AIが使いやすくなる一方で、当然別の問題も出てきます。
2023年なら、手や指の不自然さがAI画像を疑う手がかりになることがありました。
しかし、その弱点はすでに改善され続けています。
Images 2.5では、人物や構図を維持しながら細かな変更を重ねられるようになりました。
OpenAIも安全対策として、C2PAメタデータや不可視の電子透かしを継続して利用するとしています。
ここまで自然になったら、もう見た目だけではAI画像か分からなくなりませんか?
少なくとも、
「指がおかしいからAI」「顔に違和感があるからAI」
といった特徴だけに頼るのは難しくなっています。
AIフェイクを調べた記事でも、人間はAIで作られた画像や音声を毎回正確に判別できるわけではないことを顔も声も本人そっくり|AIで作られたフェイクをあなたは見抜けますか?の記事で紹介しました。
画像だけを見るのではなく、誰が公開したのか。
元の情報はどこにあるのか。
お金や個人情報を急いで求められていないか。
確認する場所を、画像の中だけに限定しないことが大切です。
AI画像が進化するほど、変なところを探すだけでは判断しにくくなります。画像を見る力と一緒に、その情報がどこから出たものなのかを見る習慣も必要になります。
では、Images 2.5でAI画像はどこまで来た?
Images 2.5を、服だけ変えても顔が変わらなくなりました。
だけで説明すると、進化を小さく見せてしまいます。
そこはNano Bananaですでに大きく前進していました。
今回見るべきなのは、そこではなく、
画像を1回直せるかではなく、何度も修正を重ねられる。
毎回長い文章で場所を説明しなくても、画像へコメントできる。
言葉で伝えにくければ、Sketchで描ける。
さらに生成時間も短くなった。
一つひとつを見ると、小さな改善に見えるかもしれません。
でも全部つなげると、意味が変わります。
AIに1枚作ってもらう。
そこで終わらず、見て、直して、また直して、完成へ近づける。
AI画像が、そこまで付き合えるようになってきました。
ブログのアイキャッチ、SNS投稿、商品画像、チラシ、プレゼン資料、そしてマンガ。
こうしたものを作るとき、最初の1枚が完璧である必要はありません。
途中で何度も直せるなら、使い方はかなり変わります。
まとめ|これからAI画像を比べるなら「5回目」を見てみたい
ChatGPT Images 2.5は、画像をさらにリアルにしただけの更新ではありません。
一部分だけを変更する編集は、Nano Bananaですでに大きく進化していました。
Images 2.5で注目したいのは、その編集を何度も積み重ねたときに、前の内容をどこまで維持できるかです。
OpenAIはそこに加えて、コメント、Sketch、テンプレート、最大50%の高速化まで投入しました。
だから、次に新しい画像AIを見たときは、最初の1枚だけを見ない。
3回直してみる。4回直してみる。5回直してみる。
そのとき最初に気に入った人物や構図がどこまで残っているか。
AI画像の進化が分かるのは、むしろそこかもしれません。
AI画像を「見る」だけでなく、実際に触ってみたい方へ
画像生成AIは、機能説明を読むだけでは違いが分かりにくい分野です。
同じ画像を作って、背景だけ変える。
もう一度直す。
さらに人物や商品の位置を変えてみる。
何度か触ってみると、「このAIはどこが使いやすいのか」が見えてきます。
生成AI未来創造スクール 大阪校では、ChatGPTやGemini、Canvaなどを実際に操作しながら学べる60分無料体験レッスンを行っています。
「自分ならAI画像を何に使える?」「ブログやSNSで使える画像を作ってみたい」という方は、作ってみたいものを一つ持ってきてください。画面を見ながら一緒に試せます。
参考情報
OpenAI「Introducing ChatGPT Images 2.5」2026年9月8日 https://openai.com/index/introducing-chatgpt-images-2-5/
OpenAI「ChatGPT Images 2.5 System Card」2026年9月8日 https://deploymentsafety.openai.com/chatgpt-images-2-5/safety-evaluations
OpenAI「ChatGPT Release Notes」 https://help.openai.com/en/articles/6825453-chatgpt-release-notes
Google「Nano Banana」関連 https://blog.google/products-and-platforms/products/gemini/nano-banana-tips/
Google「Nano Banana 2」2026年2月26日 https://blog.google/innovation-and-ai/technology/ai/nano-banana-2/
The Washington Post「AI can draw hands now」2023年3月26日 https://www.washingtonpost.com/technology/2023/03/26/ai-generated-hands-midjourney/